 SEKE研究组
SATURN论文解读——NeurIPS 2025 Spotlight paper
2026年8月5日 · 刘焕宇
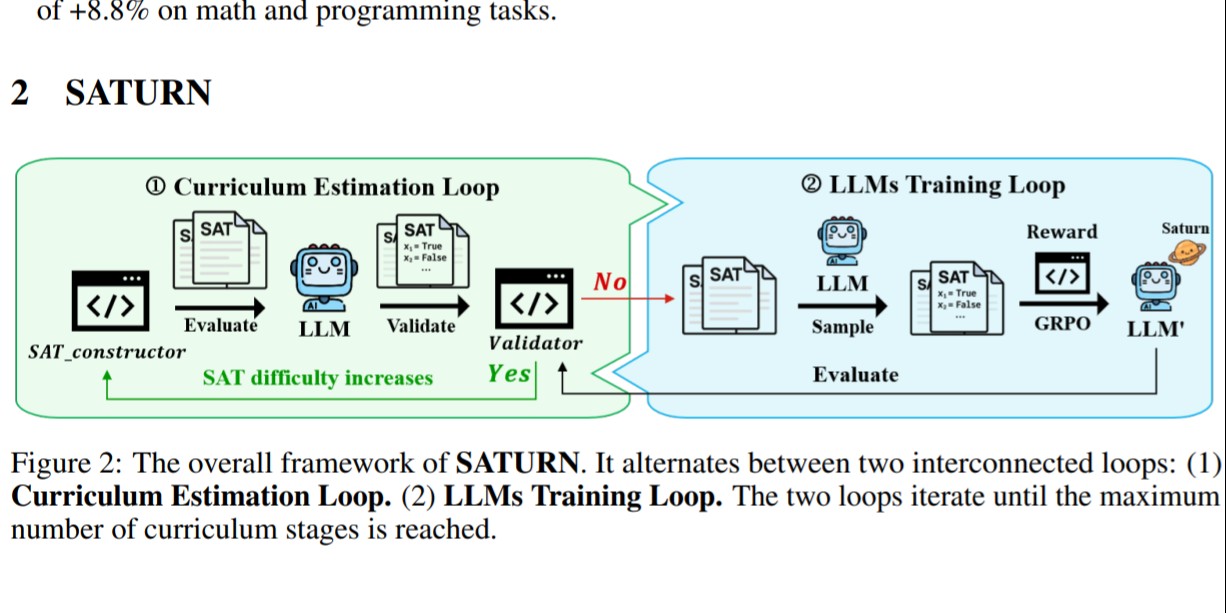
现有强化学习数据存在规模有限、人工成本高以及难度分布不均等问题,难以支撑模型推理能力持续提升。布尔可满足性问题(SAT)作为经典NP完全问题,具备自动生成、结果可验证和难度可控等优势,为强化学习训练提供了新的数据来源。本研究提出SATURN,将SAT问题引入大模型强化学习训练框架。通过启发式规则合成大规模SAT数据,通过调节变量规模、子句复杂度和约束结构实现训练难度的动态控制,引导模型从基础逻辑推理逐步向复杂推理能力演进。实验表明,在SAT训练中获得的自反思、自验证等推理能力能够迁移至数学推理和代码生成任务,提升大模型的泛化能力。
在强化学习驱动的大模型训练中,数据的可扩展性、可靠性和难度控制是决定性能提升的关键因素。现有方法通常依赖人工标注的编程题目与测试用例,虽然能够提供准确的监督信号,但标注数据规模有限,人工构造成本高。随着模型参数量和训练规模的扩展,有限的标注样本很快被消耗殆尽,难以支撑推理能力的持续提升。此外,现有标注数据的难度分布不均匀,不同难度的编程题目的数据相差较大,呈现出长尾分布的现象。
布尔可满足性问题(下文简写为:SAT问题)为解决上述困境提供了一种新颖的思路。作为计算机科学中经典的 NP 完全问题,SAT 问题拥有扎实的理论背景和高效的验证机制。从强化学习训练的角度看,SAT问题具备三方面优势。(1)数据的可扩展性:SAT问题能够通过启发式规则自动合成,不依赖人工标注或大模型合成,数据规模可以持续扩展,为强化学习训练提供了充足的数据资源。(2)结果的可验证性:SAT问题的解答的正确性可以在多项式时间内完成验证,奖励信号既准确又高效,避免了模糊或不确定反馈带来的训练不稳定性。(3)难度的可控性:通过调节变量数量、子句复杂度和约束结构,可以构造不同难度的SAT问题,使模型能够在难度平滑递进的环境中提升能力。
本研究SATURN将 SAT问题引入强化学习训练。通过启发式规则合成大规模 SAT问题,可以在极低成本下为强化学习持续供给训练数据。验证过程可借助标准化的 SAT求解器自动完成,确保奖励信号的可靠。更为关键的是,难度可控机制使得训练过程能够根据模型的当前表现有序推进:在初始阶段,简单的SAT问题帮助模型快速掌握基本逻辑推理能力;在后续阶段,更复杂的SAT问题逐步引导模型向深度推理扩展。这些原子能力(自反思、自验证)一旦在 SAT问题上得到强化,便可以泛化到数学推理、代码生成任务中。
我们将 SATURN 应用于 DeepSeek-R1-Distill-Qwen,得到 SATURN-1.5B 和 SATURN-7B 两个模型,并取得了以下显著成果:
1. 在 SAT 问题上,SATURN-1.5B 和 SATURN-7B 的平均 pass@3 指标分别提升 +14.0 和 +28.1。
2. 在数学推理和编程任务上,SATURN-1.5B 和 SATURN-7B 在多个基准测试(如 AIME、LiveCodeBench)上的平均得分分别提升 +4.9 和 +1.8。
3. 与当前构建强化学习任务的最先进方法相比,SATURN 进一步实现了 +8.8% 的性能提升。
我们已公开发布源代码、数据集和模型,以支持后续相关研究,项目地址:https://github.com/gtxygyzb/Saturn-code。