 SEKE研究组
EvoCoT论文解读——ACL 2026
2026年8月5日 · 刘焕宇
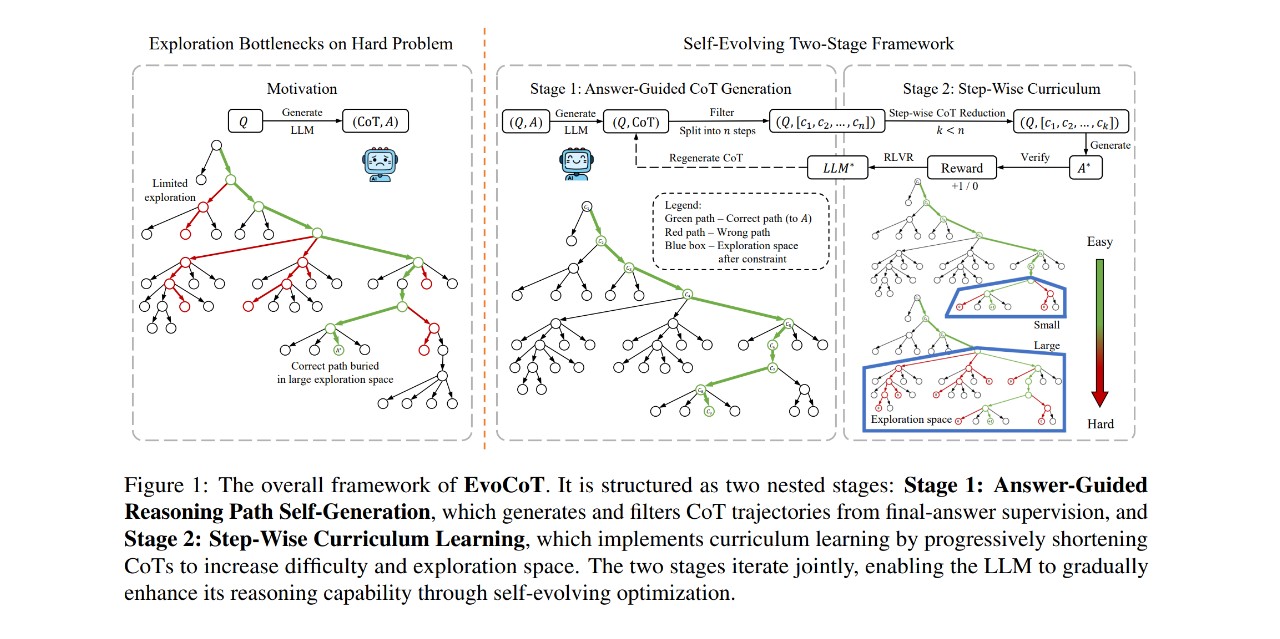
RLVR已成为提升大语言模型推理能力的重要方法,但在困难问题上,由于模型初始采样准确率较低,奖励信号稀疏,导致模型难以有效探索。现有方法通常依赖教师模型生成推理轨迹或过滤困难样本,限制了训练的可扩展性和模型进一步探索能力。本文提出 EvoCoT,一种基于两阶段思维链(CoT)优化的自进化课程学习框架。EvoCoT 首先通过模型自身生成并验证 CoT 轨迹,构造有效的推理路径以缓解探索瓶颈;随后逐步压缩 CoT 推理步骤,引导模型在受控范围内扩大探索空间并学习更高效的推理策略。
在基于可验证奖励的强化学习(RLVR)中,模型通常通过采样推理轨迹并根据最终答案的正确性获得奖励。然而,对于复杂问题,由于初始模型的推理能力有限,其生成的多数轨迹可能无法得到正确答案,导致奖励信号极度稀疏。当模型在某类问题上的 rollout accuracy 接近于零时,传统 RL 方法难以获得有效的优化方向,从而陷入探索瓶颈。现有方法主要通过引入更强教师模型生成 Chain-of-Thought(CoT)轨迹进行蒸馏,或直接过滤掉模型无法解决的困难样本以缓解这一问题。然而,前者依赖额外的高质量推理数据,限制了方法的可扩展性;后者则减少了模型探索未知问题的机会,限制了推理能力的进一步提升。
为解决上述问题,我们提出 EvoCoT,一种基于两阶段 CoT 优化的自进化课程学习框架。EvoCoT 的核心思想是通过动态调整推理轨迹的复杂度,逐步扩大模型的探索空间,使模型能够从原本无法解决的困难问题中获得有效学习信号。具体而言,EvoCoT 首先执行 CoT Bootstrapping 阶段,给模型问题和答案,利用模型自身的探索能力生成候选推理轨迹,并通过可验证奖励筛选出正确的 CoT 轨迹。与依赖外部教师模型的蒸馏方法不同,该阶段通过模型自身生成和验证推理过程构造训练信号,从而降低对人工标注或强模型监督的依赖。同时,正确 CoT 轨迹为模型提供了可学习的推理路径,有效缩小了困难问题上的探索空间。
在获得稳定的推理轨迹后,EvoCoT 进一步引入 CoT Reduction 阶段,逐步减少模型对完整推理链的依赖。具体而言,该阶段通过压缩中间推理步骤,使模型在保持正确性的同时探索更加紧凑的推理模式。随着 CoT 长度从后往前逐渐缩短,模型需要自主发现更高效的推理策略,从而实现从受约束探索到开放探索的平滑过渡。该过程形成了一种由易到难的自进化课程学习机制,使模型能够稳定学习原本因稀疏奖励而难以优化的问题。直至把CoT完全删去,模型在RL见到问题即可回答出答案,解决原来不会的难题。
通过上述机制,EvoCoT 在无需外部 CoT 监督的情况下,有效缓解了 RLVR 中的探索瓶颈,并提升了大语言模型的复杂推理能力。我们将 EvoCoT 应用于多个模型系列(包括 Qwen、DeepSeek 和 Llama),实验结果表明,该方法能够帮助模型解决此前无法完成的问题,同时兼容多种强化学习算法,并在数学推理、代码生成等任务中取得稳定提升。